Видео с ютуба Ternary Quantization

Ternary Mamba — Ternary Quantization-Aware Training (QAT), explained

Как LLM выживают в условиях низкой точности | Основы квантования

1-Bit LLM: The Most Efficient LLM Possible?

Ternary weights explained in 8min..
The myth of 1-bit LLMs | Quantization-Aware Training

История о «зерне» на 7 ГБ: запускаем локальные нейросети на слабом ПК

What Are Ternary & 1-Bit AI Models Explained | Run AI With Almost No Memory

Ternary Computing Explained: Why Setun Lost in 1965 and Why AI Models Use Three States

A Free 27B Coding Model Fits on Your Laptop—But Can It Replace Cursor?

Ternary Weights, 3-Bit KV Caches, and the Limits of Quantization | Bangalore Paper Club

Преодоление 1,58-битного барьера для тернарных LLM (сентябрь 2026 г.)

Преодолеваем барьер в 1,58 бита для тернарных LLM

I Just Tried The Brand New Ternary Model And It's Great!

Шерри: Аппаратно-эффективное 1,25-битное троичное квантование с помощью мелкозернистого разрежения

How BitNet b1.58 Runs LLMs With Just 1.58-Bit Weights

Ternary Bonsai 27B on 8GB: What Actually Fits?

Absmean Quantization: How 1.58-Bit AI Actually Works (Part 2)

BitNet b1.58 How 1.58-Bit Ternary Weights Run LLMs on CPUs Without GPUs

How a 54GB AI Model Fits on a 12GB GPU | Quantization & Ternary Bonsai
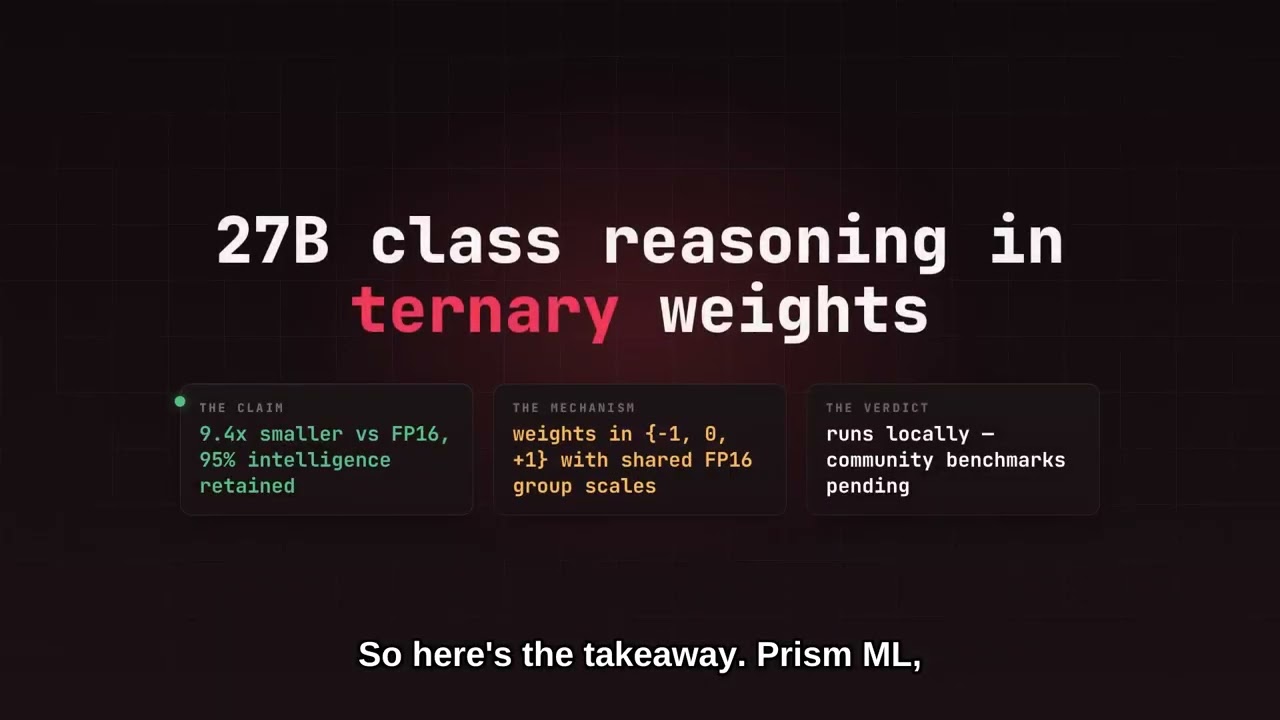
Ternary-Bonsai-27B Explained: Ternary-Quantized GGUF LLM Deep Dive